비정형 문서 처리 한계
PDF, HWP, DOCX, 이미지처럼 형식이 제각각인 문서를
AI가 읽을 수 있게 바꾸려면 변환과 정제에 많은 시간이 걸립니다.

 DeepDocurator
사내 문서, 매뉴얼, 정책, 보고서, PDF를 AI가 자동으로 수집 · 분석 · 정제하여
검색, 질의응답, Agent 업무 자동화에 바로 연결되는 지식베이스로 전환합니다.
PDF, HWP, DOCX, 이미지처럼 형식이 제각각인 문서를
AI가 읽을 수 있게 바꾸려면 변환과 정제에 많은 시간이 걸립니다.
표, 이미지, 문단 흐름이 제대로 읽히지 않으면
AI가 중요한 내용을 놓치거나 잘못 해석해 답변 품질을 믿기 어렵습니다.
문서가 많아질수록 파싱, 정제, 임베딩, 저장, 오류 재처리까지
수작업으로 관리해야 할 일이 늘어나 운영 부담이 커집니다.
문서를 어떤 기준으로 나누고 태깅해야 할지 정하기 어려워
RAG를 구축해도 원하는 답을 안정적으로 찾기 어렵습니다.
 DeepDocurator
다양한 포맷의 문서를 수집부터 OCR·파싱·청킹·임베딩·인덱싱까지 자동화하여 AI가 활용할 수 있는 지식 데이터로 변환합니다.
Contact us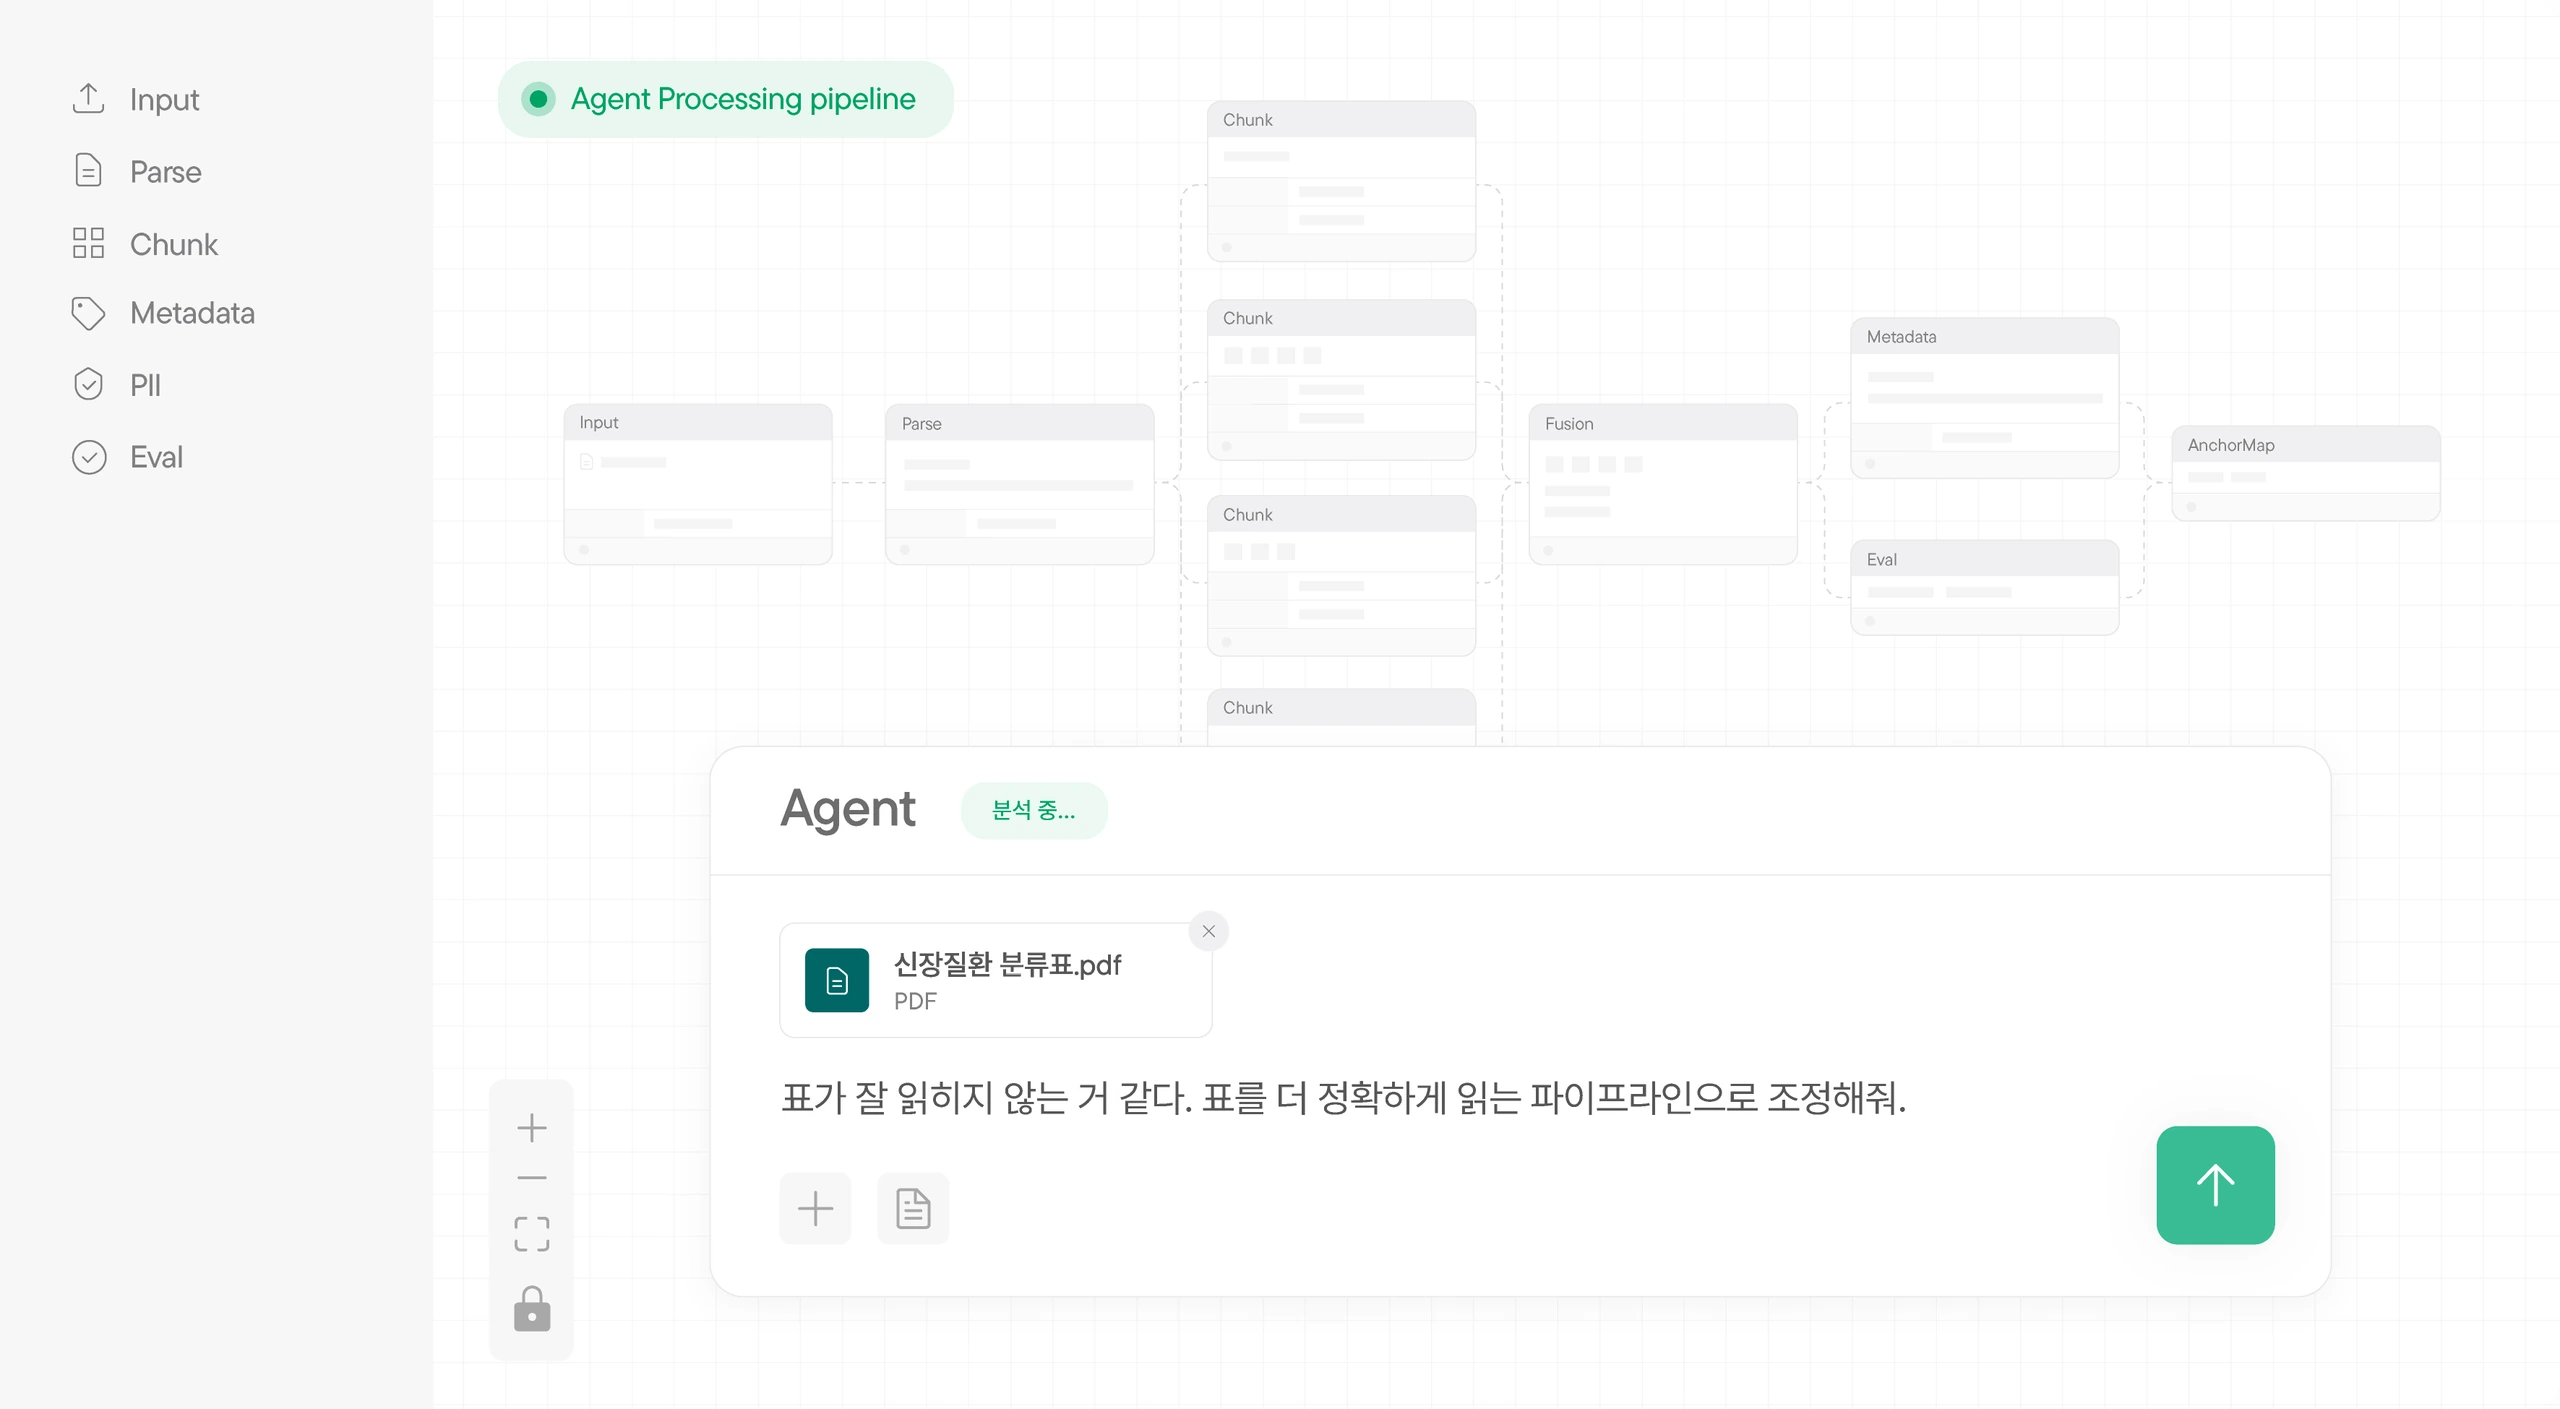
이기종 사내 시스템부터 다양한 문서 포맷까지 단일 파이프라인으로 데이터 수집 체계를 구축합니다.
OCR부터 Indexing까지 전 단계를 자동화하고, 자연어 검증·보정으로 대량 문서 처리 품질을 고도화합니다.
파이프라인 에이전트가 다중 청킹 전략을 자동 실험 · 평가해, 문서별 최적 RAG 파이프라인을 자동 구성합니다.
문서 프로필·전략·평가 점수를 자동 축적해 유사
문서가 오면 과거 최적 전략을 즉시 참조합니다.
에이전트가 여러 처리 전략을 동시에 실험해
가장 좋은 결과를 자동으로 골라 반환합니다.
Eval이 처리 결과를 자동 채점 · 검증해 일관된
품질을 유지하고, 점수는 다시 노하우로 쌓입니다.
체크포인트 · 재시도 · 중복 방지 기반 일괄 적재로 대량 지식을 안전하게 구축하고,
변경분 자동 수집과 어댑터 확장으로 운영 효율성을 지속 확보합니다.
특장점 1
사내 기존 시스템 내 지식과 다양한 문서를 수집하고,
자연어 요청으로 문서별 처리 전략을 자동 설계합니다.
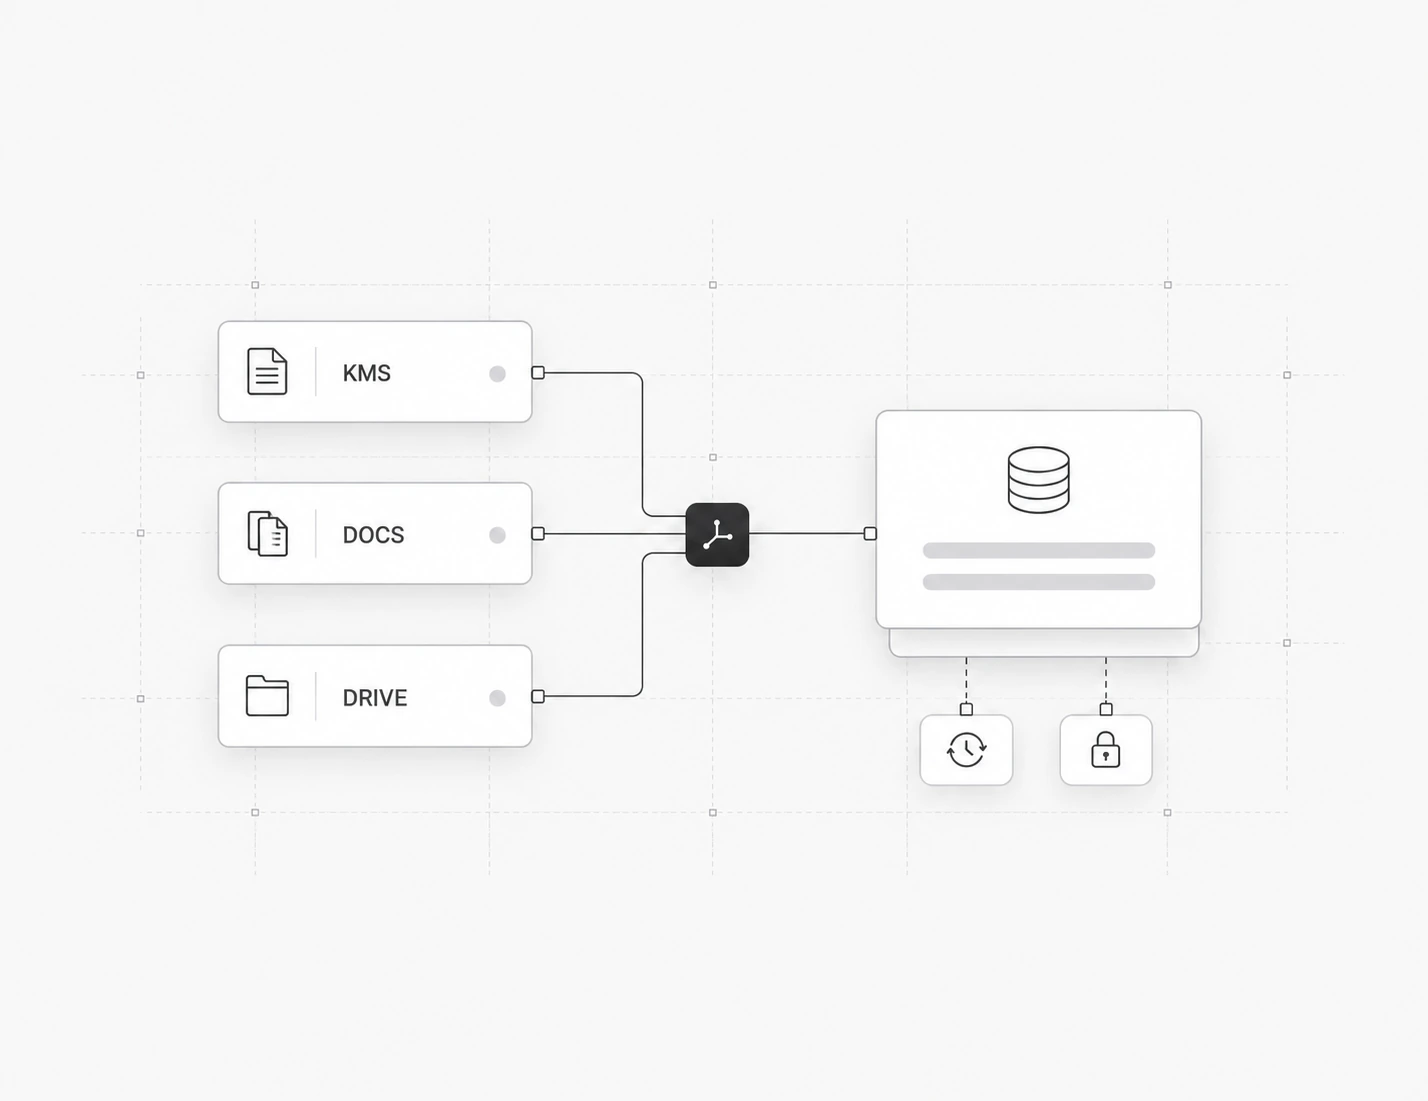
이기종 사내 시스템(KMS·그룹웨어·웹하드 등)을 연동해
데이터를 수집하고, 수집 주기와 권한 정책을 함께 관리합니다.
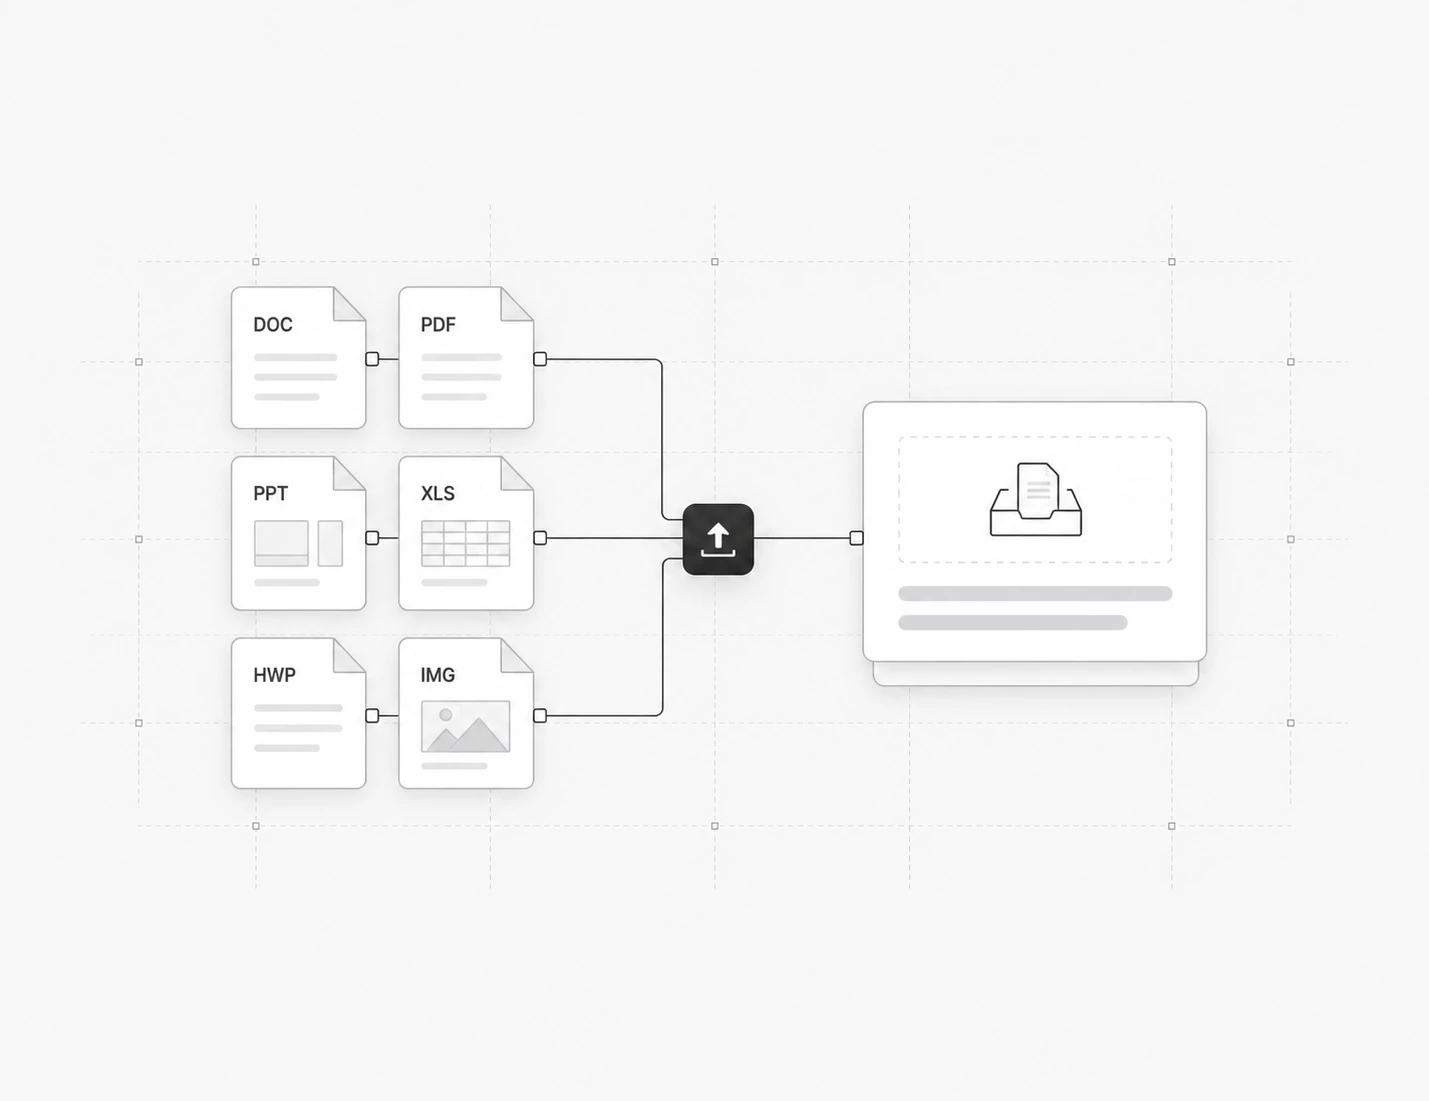
다양한 포맷(DOC, PPT, XLS, PDF, HTML, TXT, HWP,
이미지 등)의 문서를 업로드하고 처리할 수 있습니다.
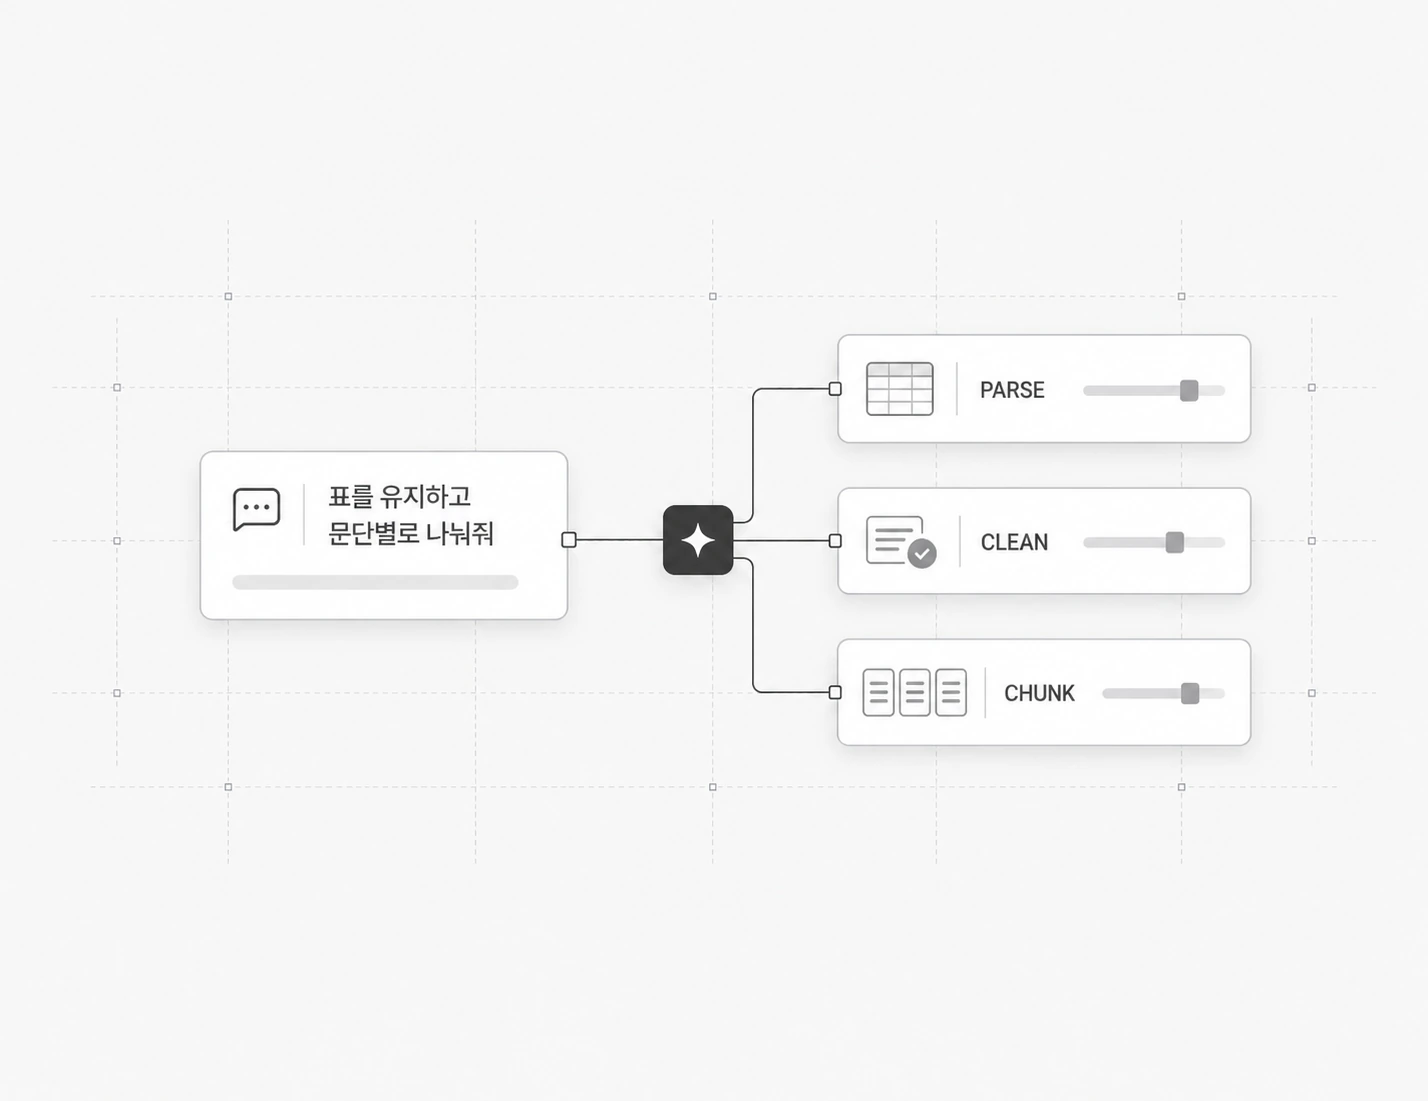
담당자가 자연어로 업무 요건을 입력하면, 동일한 문서라도
목적에 맞는 파싱·청킹 전략을 자동으로 적용합니다.
특장점 2
파이프라인 에이전트가 다중 청킹 전략을 실험·정량 평가하고 최적안을 선정·배포해,
자동으로 최적의 RAG 파이프라인을 구성합니다.
 분석 중...
 신장질환 분류표.pdfPDF


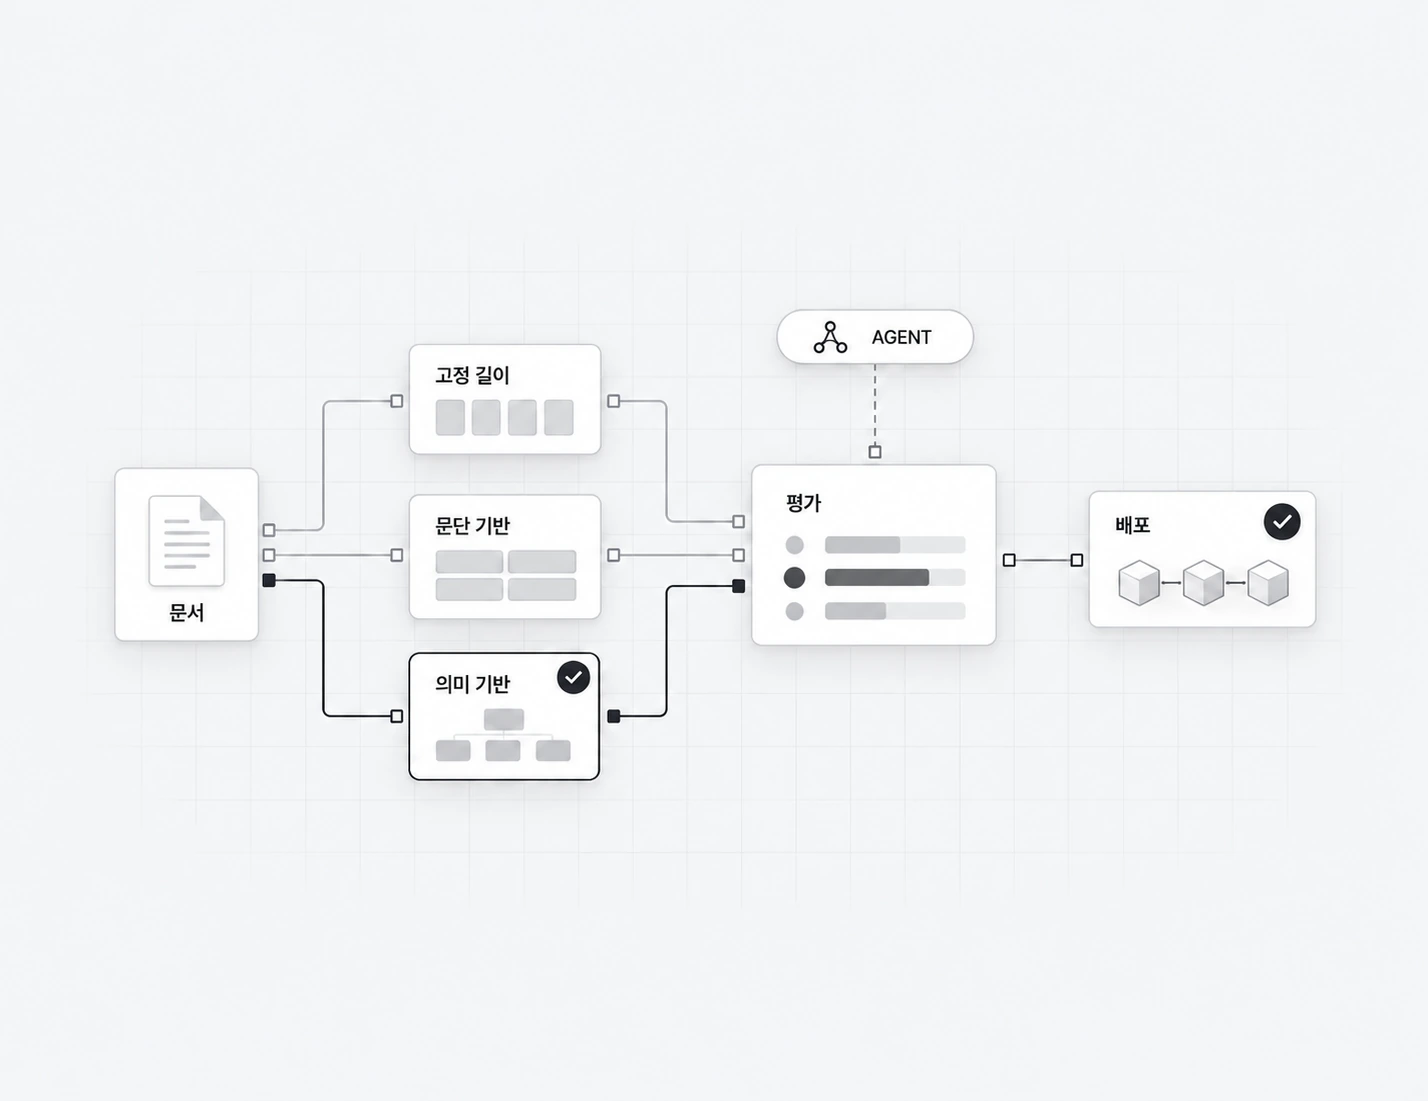
업로드한 문서 기반으로 청킹 전략을 지식베이스에 저장
유사 문서 업로드 시 축적된 전략을 종합해 청킹 수행
에이전트가 가능한 청킹 전략을 빠르게 탐색해 최적의 청킹 제안
자동 평가 스코어를 기준으로 최적 전략을 결정
특장점 3
문서 유형과 처리 목적에 따라 파싱 · 모델 · 처리 방식을 선택하고
데이터 파이프라인을 최적화하는 기능을 제공합니다.

PDF, 이미지, 엑셀 등 문서 유형에 따라
최적의 Parser와 OCR 프로바이더를 선택합니다.
텍스트 생성과 청킹에 필요한 LLM을 선택해
문서 처리 목적에 맞게 설정합니다.
이미지, 표, 도식이 포함된 멀티모달 문서를
이해할 수 있도록 VLM을 설정합니다.
특장점 4
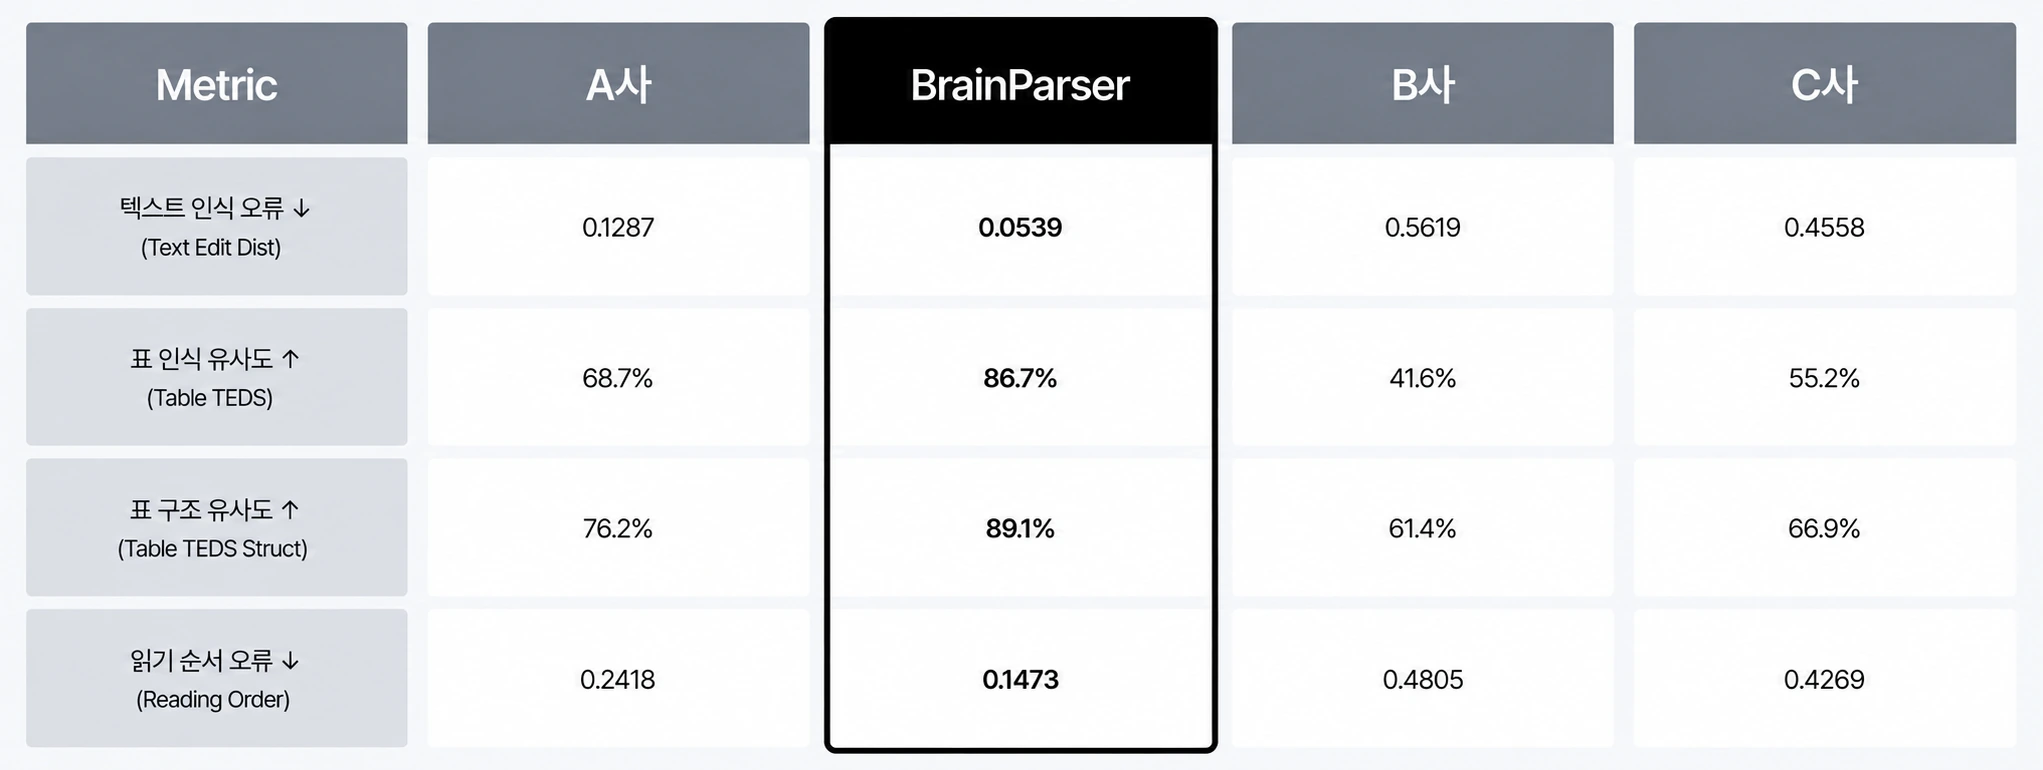
브레인크루 자체 개발 BrainParser를 기본 적용해, OmniDocBench 4개 지표에서 1위를 기록한 높은 파싱 정확도를 제공합니다.
전사 문서를 RAG 투입 가능한 형태로 자동 변환
이기종 포맷 매뉴얼을 한 번에 정리
원본 · 버전 · 메타데이터까지 일관되게 정제
투입한 문서를 쓸 수 있는 지식으로 변환하며,
정제된 결과는 DeepConnect의 문서 DB로 바로 이어져 RAG · Agent에 즉시 활용할 수 있습니다.

PDF · 한글 · 엑셀 · 이미지 · 코드

최적 정제 방법 선택

포맷 · 구조 자동 처리

AI 자동 채점 · 저장
단독 도입도, 4단계 통합 AX 스택으로도 확장 가능하며,
고객 데이터 · 환경 · 규제 요건에 맞춰 맞춤 설계해드립니다.


